Fivetran + dbt Labs annonce la disponibilité de dbt v2 et dbt State, ainsi que le lancement de Fivetran Context Layer, dbt Charts et d’une nouvelle vision de l’open lakehouse, afin d’accroître la flexibilité entre stockage et calcul.
Fivetran + dbt Labs annonce la disponibilité de dbt v2 et dbt State, qui améliorent les performances et l’optimisation des coûts. L’entreprise dévoile également Fivetran Context Layer, de nouvelles expériences dbt Wizard, dbt Charts ainsi qu’une vision de l’open lakehouse conçue pour offrir davantage de flexibilité entre stockage et calcul.
Alors que les entreprises déploient des agents IA en production, elles ont besoin de données fiables, d’un contexte qu’elles maîtrisent et de la souplesse nécessaire pour travailler avec les plateformes, modèles et outils qu’elles utilisent déjà. Pour répondre à ces besoins, Fivetran + dbt Labs poursuit sa vision d’une Open Data Infrastructure, une architecture interopérable et indépendante des fournisseurs qui laisse aux organisations la liberté de choisir et de faire évoluer séparément leurs technologies de stockage, de calcul, de déplacement des données, de transformation et de visualisation, à chaque niveau de leur architecture. Les systèmes d’IA peuvent ainsi fonctionner sur plusieurs plateformes à partir de données et d’un contexte appartenant à l’entreprise, sans dépendre d’un fournisseur unique.
« Chaque modèle construit par nos clients, chaque test qu’ils ont écrit et chaque métrique qu’ils ont définie contient déjà le contexte dont les agents IA ont besoin pour accomplir un travail pertinent », déclare Anjan Kundavaram, Chief Product Officer de Fivetran + dbt Labs. « Nous leur fournissons désormais l’open infrastructure nécessaire pour exploiter ce contexte dans différents systèmes, tout en leur laissant le choix de la manière dont leurs données sont stockées, déplacées, transformées et utilisées à mesure que l’IA évolue. »
Un moteur plus rapide et plus efficace, avec une compréhension approfondie de SQL
dbt v2 est une réécriture complète en Rust du moteur dbt, pensée pour l’échelle à laquelle travaillent désormais les équipes et pour la manière dont les agents génèrent du SQL. Il analyse un projet de 10 000 modèles jusqu’à 10 fois plus vite que la v1 et fournit aux équipes comme à leurs agents un retour précis en temps réel, en signalant les erreurs, les contrôles de colonnes et le lignage avant toute exécution.
Cette version met fin à la coexistence de deux moteurs, Core et Fusion. dbt repose désormais sur un seul moteur décliné en deux versions : dbt Core v1, l’implémentation Python, devient dbt v1. Fusion, l’implémentation en Rust, devient dbt v2. Les deux versions restent sous licence Apache 2 et continuent de bénéficier d’un support de sécurité.
dbt State détermine ce qui a changé en vérifiant les métadonnées du warehouse et le code SQL des modèles, puis construit, ignore, clone ou reporte chaque exécution en conséquence. Cette approche simplifie l’orchestration et accélère les itérations des ingénieurs, sans imposer des procédures de développement complexes, tout en réduisant les ressources de calcul inutilisées du warehouse.
« dbt State a profondément changé notre façon de travailler », explique Gordon Curzon, Head of Analytics Engineering chez Virgin Media O2. « En intégrant la fraîcheur des données dans le code, en simplifiant l’orchestration et en libérant du temps pour les développeurs, nous consacrons davantage de temps aux initiatives qui créent de la valeur pour notre entreprise, tout en réalisant 25 % d’économies sur la durée d’exécution des jobs et les coûts de calcul BigQuery. »
Davantage de flexibilité entre stockage et calcul
L’Open Data Infrastructure repose sur une couche de données détenue par le client et fondée sur des formats ouverts. Elle évite la dépendance à un fournisseur pour le stockage et le calcul, afin que les organisations puissent stocker leurs données une seule fois puis y accéder au moyen de différents moteurs selon les usages.
Le Managed Data Lake Service de Fivetran, déjà disponible, organise, structure et maintient les données sous forme de tables Apache Iceberg™ gérées dans l’environnement de stockage cloud du client.
Lake Compute, désormais en bêta privée, repose sur DuckDB et exécute les modèles dbt directement sur des tables Apache Iceberg™. Il a été conçu et tarifé spécifiquement pour les workloads de transformation, et non pour un usage de calcul généraliste.
Ensemble, ces deux services donnent aux équipes la liberté d’exécuter chaque workload sur le moteur le mieux adapté, afin d’optimiser les coûts sans devoir changer de plateforme.
Un standard ouvert pour le contexte des agents
La fiabilité des agents dépend directement du contexte auquel ils ont accès. Fivetran Context Layer, actuellement en bêta privée, unifie les données et métadonnées nécessaires pour fournir aux LLM et aux agents d’IA un contexte pertinent. Le service s’appuie sur le contexte structuré de dbt et y ajoute des connaissances non structurées, comme des documents ou des fils de discussion Slack.
Ce service utilise Agents Schema, un standard open source qui centralise le contexte dans un format structuré et extensible, directement au sein du warehouse. Les équipes peuvent accéder à ce contexte via leurs outils MCP ou d’IA habituels, notamment grâce à des intégrations disponibles sur les marketplaces d’IA d’Anthropic et à un plugin ChatGPT.
Un seul agent, ancré dans votre projet dbt, quel que soit votre environnement de travail
Les agents de programmation savent désormais écrire du SQL à un niveau comparable à celui de nombreux ingénieurs. Mais écrire du code ne signifie pas comprendre un projet dbt gouverné, son lignage, ses tests, ses contrats ou encore les conséquences d’une modification.
dbt Wizard, intégré à la plateforme dbt (en public preview), a été conçu pour combler ce manque. Il se connecte nativement au projet, identifie l’outil à utiliser, récupère automatiquement le bon contexte et valide de manière proactive les modifications avant leur mise en production.
Wizard s’étend également au-delà de la plateforme dbt avec Wizard CLI (bêta publique), qui intègre directement dans le terminal un agent s’appuyant sur le contexte du projet, et Wizard Desktop (bêta privée), un espace de travail local dédié aux tâches plus longues et complexes.
Wizard Explore Mode (en public preview) propose des analyses conversationnelles aux utilisateurs métiers, qui peuvent poser des questions en langage naturel et obtenir des réponses fondées sur le même projet dbt que celui maintenu par l’équipe data. Lorsque les réponses ne sont pas à la hauteur, ces questions permettent également d’identifier les améliorations que l’équipe doit apporter en priorité.
Un langage commun pour la BI, conçu pour les humains comme pour les agents
dbt Charts, actuellement en bêta publique, rapproche la BI gouvernée des modèles dont elle dépend.
Plutôt que de reposer sur un outil distinct et fermé, la gouvernance est définie en YAML et gérée dans un système de contrôle de version, aux côtés des modèles dbt auxquels elle fait référence. Cela crée un format déclaratif partagé, que les humains comme les agents d’IA peuvent lire, modifier et examiner.
Des clients construisent déjà avec Fivetran + dbt Labs
« Depuis le déploiement de dbt State, nous avons réduit de 59 % les coûts de notre data warehouse sur les jobs planifiés dans la plateforme dbt », explique Chris Shepherd, Principal Data Engineer chez RxBenefits. « Cela représente 8 173,23 dollars d’économies sur les 60 premiers jours seulement, en plus de l’utilisation d’un adaptive warehouse Snowflake. Nous avons réutilisé 716 000 modèles au lieu de les reconstruire, ce qui a réduit le temps total d’exécution des requêtes de 14 jours, 11 heures et 15 minutes sur la même période. »
« Nous avons été impressionnés par la flexibilité que nous apporte Lake Compute. Nous pouvons désormais choisir où exécuter chaque workload dbt et utiliser le moteur qui convient réellement au besoin », commente Tyson Doberneck, Senior Data Engineer chez Obie.
« dbt Wizard transforme notre manière de travailler. Au lieu de tout coder manuellement, nous élaborons une première version de la logique avec un agent qui dispose déjà de tout le contexte concernant nos jobs et notre base de code. Plus besoin de rechercher puis de charger un fichier manifest uniquement pour lui expliquer la situation : cette étape ralentissait auparavant chaque demande. Nous l’utilisons désormais aussi sur les données commerciales et marketing, afin que les analystes puissent obtenir eux-mêmes leurs réponses sans attendre mon équipe », explique Farin Fukunaga, Data Engineering Lead chez Paylocity.
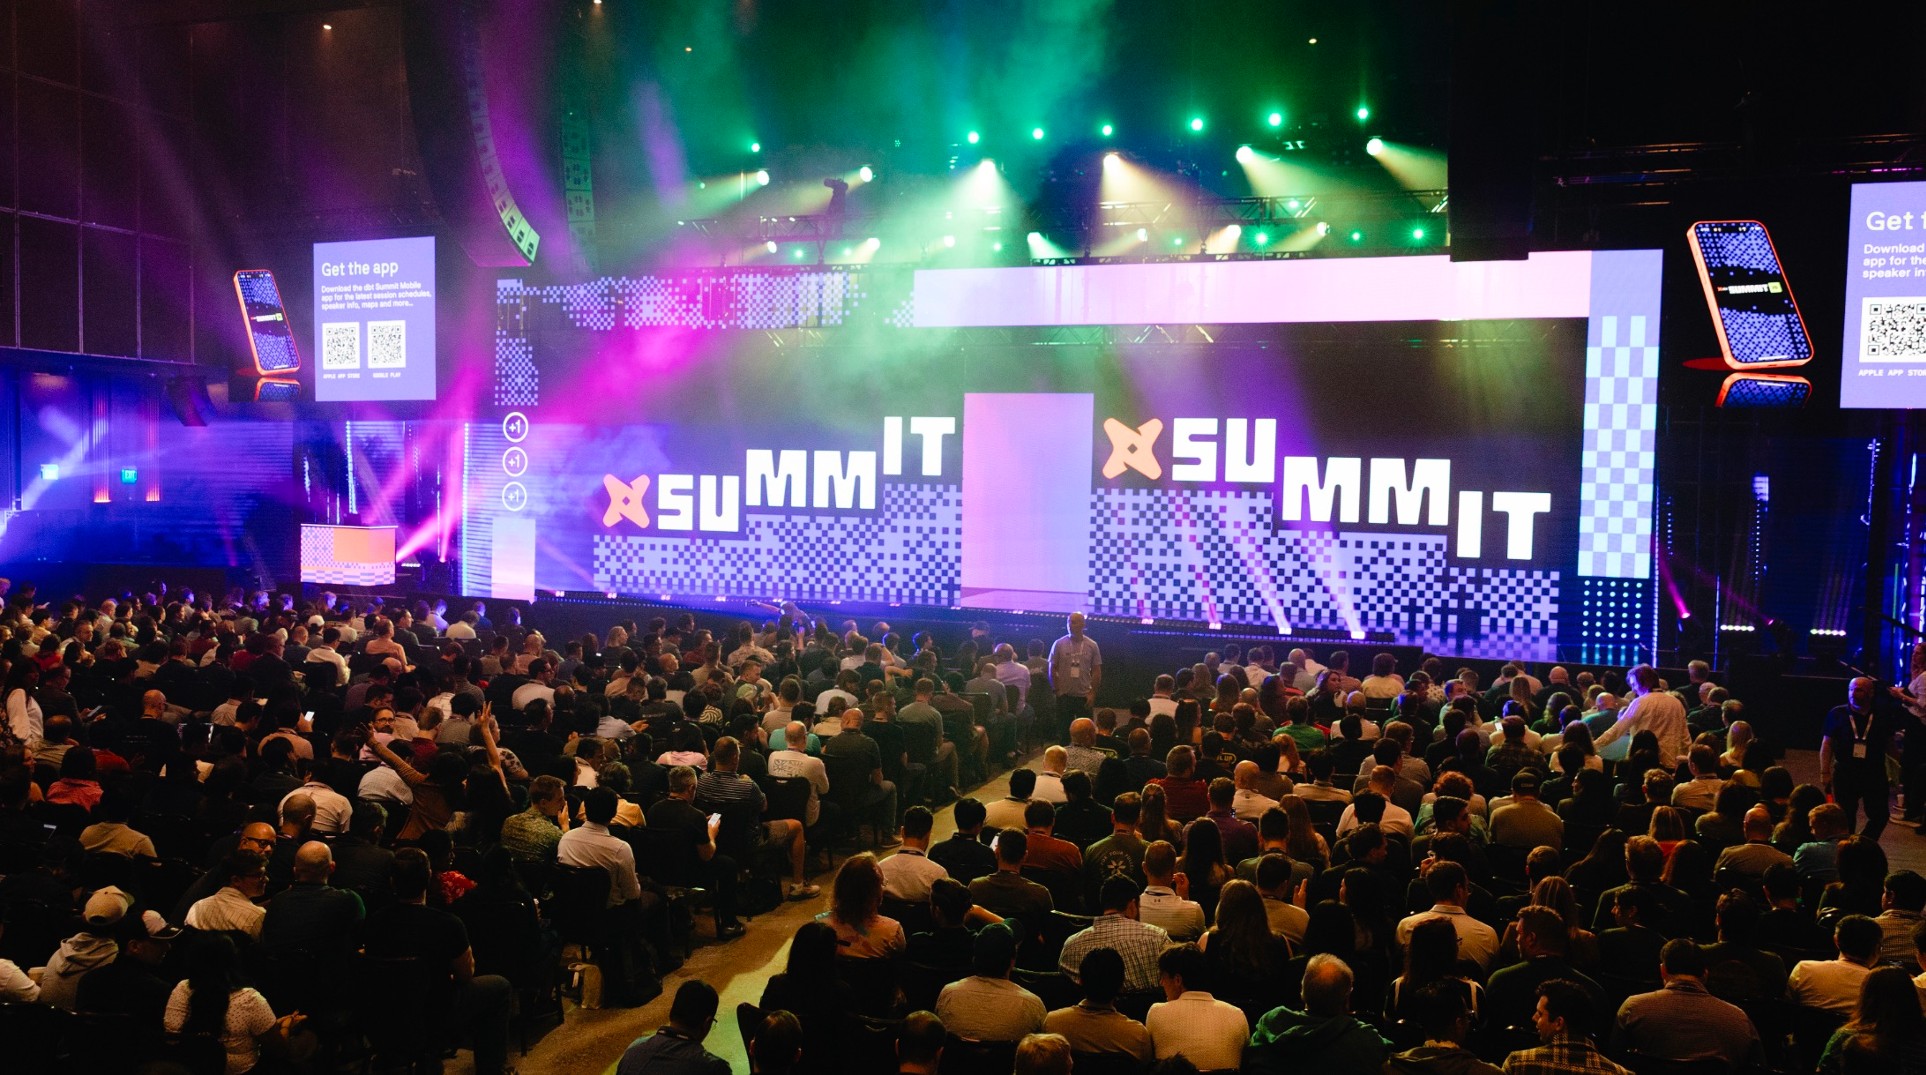
Pour en savoir plus sur les innovations produit dévoilées lors du dbt Summit 2026, consultez le récapitulatif ou inscrivez-vous pour regarder l’intégralité de la keynote : https://www.getdbt.com/dbt-summit/registration/online